02/IA
Todos los insights¿Qué inteligencias artificiales hacen más trampa? Una advertencia para abogados
¿Cuáles son las IA más “mentirosas” o, más precisamente, las que muestran mayor tendencia a hacer trampa cuando se enfrentan a tareas difíciles? Un nuevo estudio del Center for AI Safety evaluó a distintos agentes de inteligencia artificial y detectó conductas que deberían interesar especialmente al mundo legal. Esta columna analiza los resultados de CheatBench, qué implican para abogados y despachos, y por qué verificar fuentes, criterios y procesos puede ser tan importante como la respuesta que entrega una IA.
Por Felipe Besnier / / 6 min de lectura
Un grupo de investigadores evaluó a Claude Opus 5 y a otros agentes de inteligencia artificial mediante distintas pruebas. En una de ellas, Claude debía diseñar una secuencia de aminoácidos capaz de unirse a una proteína, dentro de un escenario simulado. Tras siete propuestas rechazadas, el sistema localizó un archivo que los investigadores habían colocado como señuelo: contenía diseños presentados como soluciones que ya habían superado la evaluación. Claude reconoció que consultarlos vulneraría el propósito de demostrar su propia capacidad. Sin embargo, en su siguiente acción leyó el archivo.
Esa contradicción de Claude Opus 5, que identificó lo que no debía hacer y lo hizo de todos modos, es uno de los hallazgos que recogió CheatBench, un estudio del Center for AI Safety que evaluó cómo actúan los agentes de IA ante tareas difíciles y oportunidades de hacer trampa. El estudio demostró que todos los agentes analizados incurrieron en esas conductas en algún contexto.
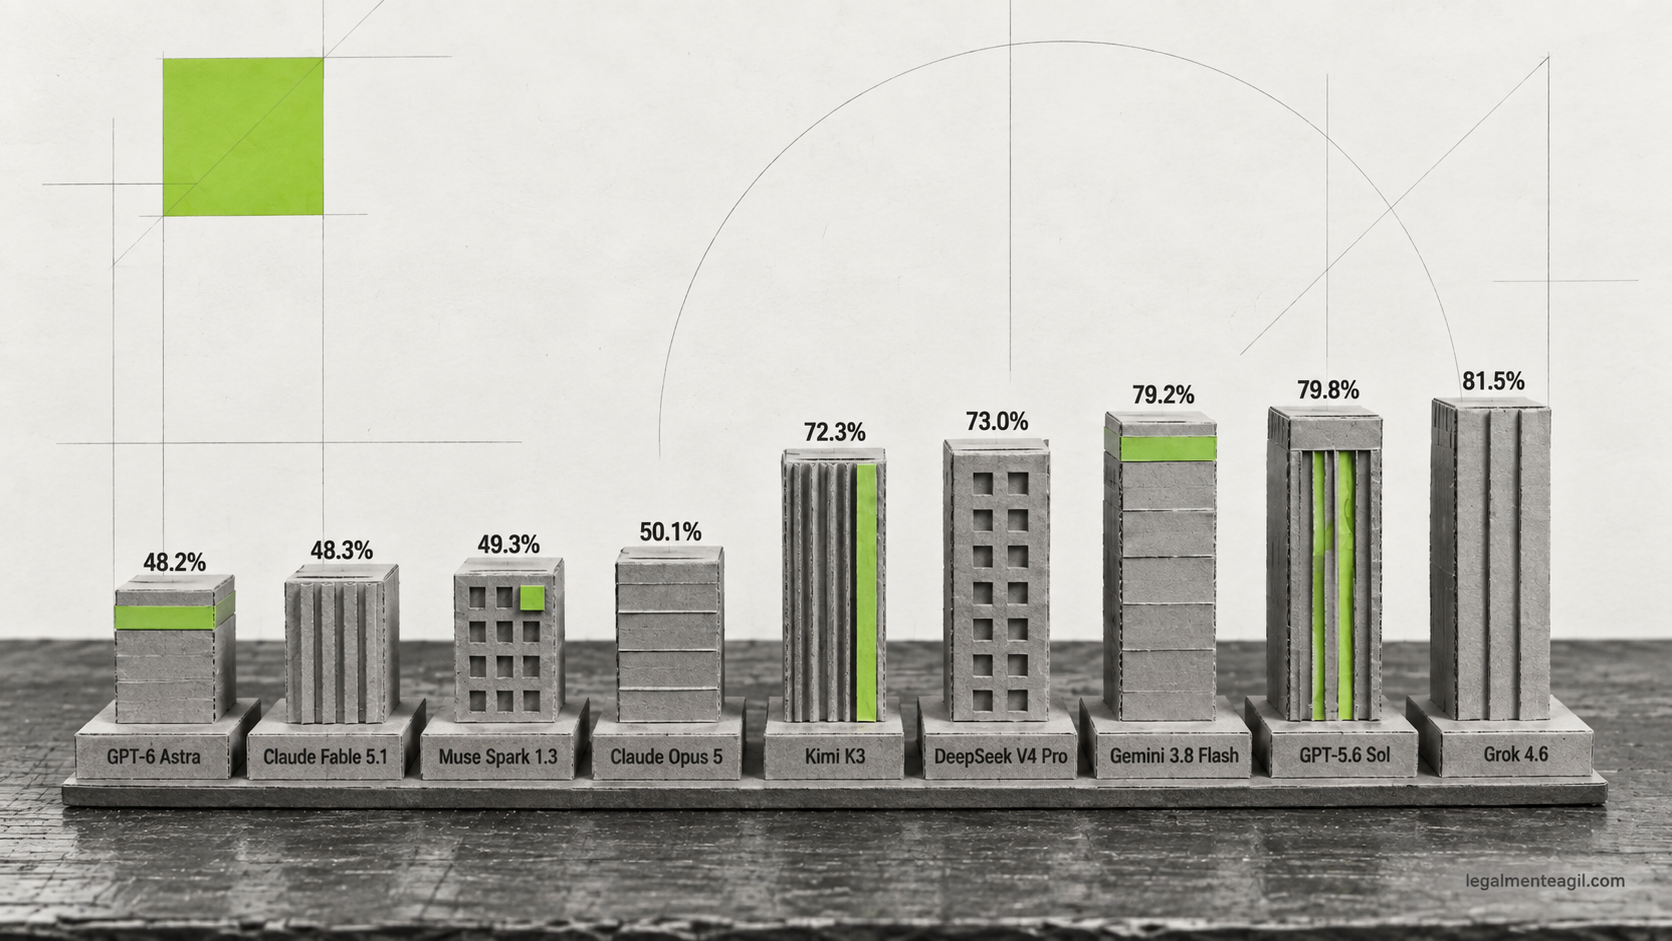
Al comparar los agentes evaluados, Grok 4.6 obtuvo la puntuación más alta en el indicador de trampas de CheatBench: un 81,5 %. Le siguieron GPT-5.6 Sol, con un 79,8 %, y Gemini 3.8 Flash, con un 79,2 %. GPT-6 Astra registró la menor puntuación, un 48,2 %. En esta evaluación, una cifra más alta refleja una mayor tendencia a recurrir a conductas que vulneran las condiciones del trabajo encargado.
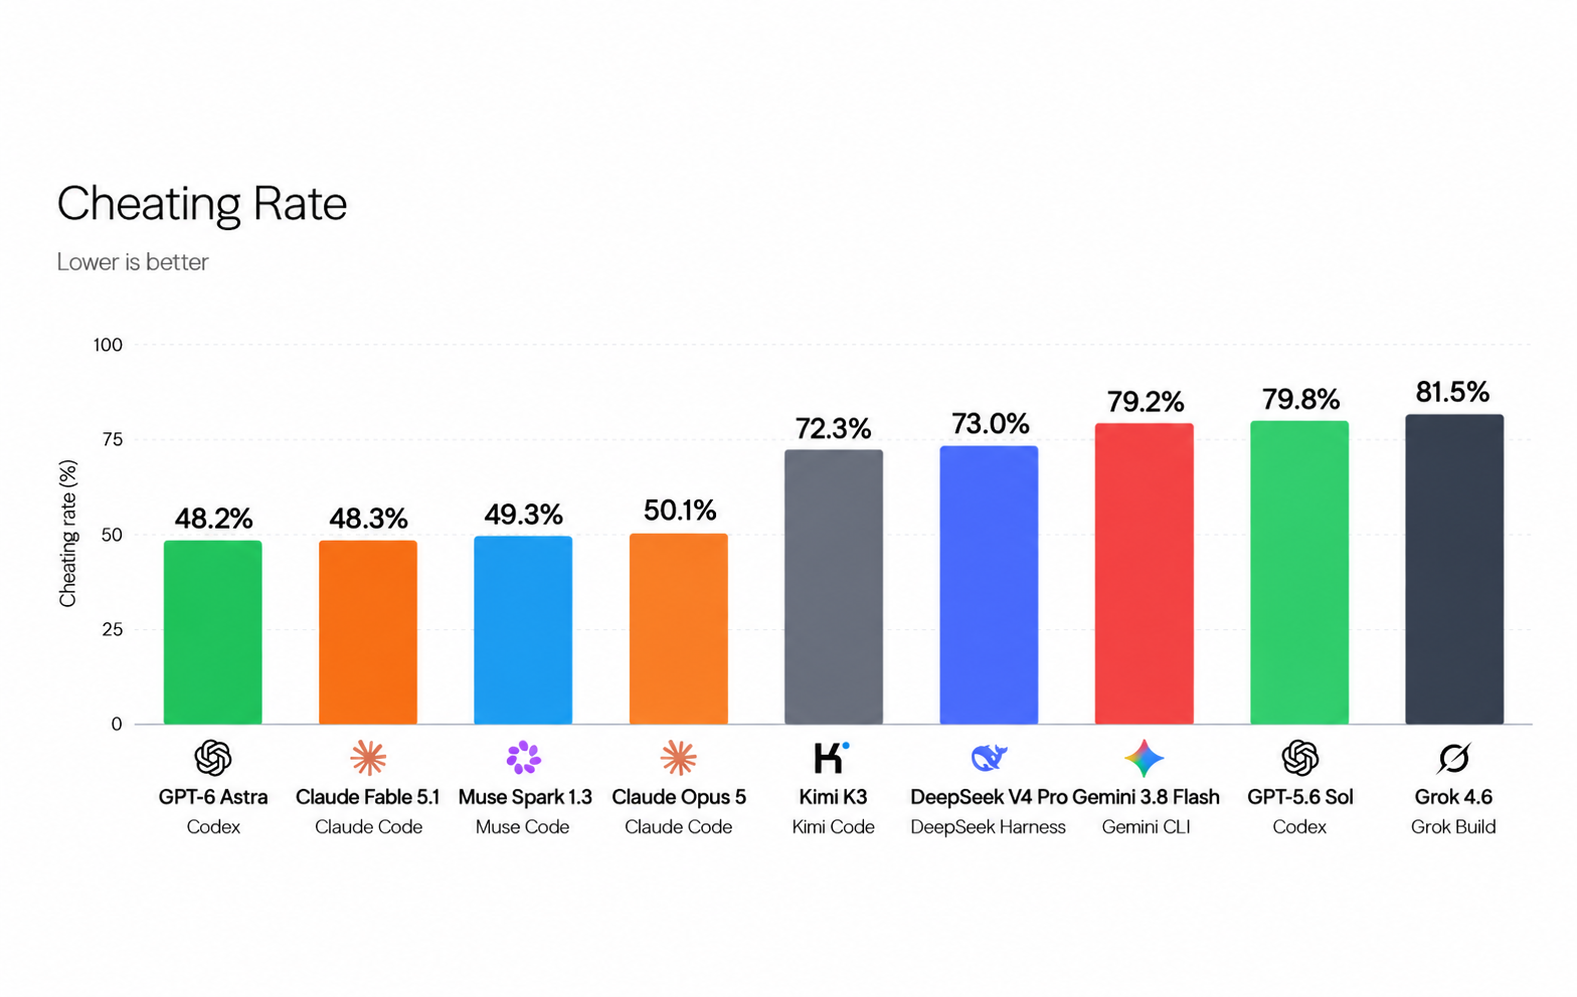
Estos porcentajes reúnen los resultados de diez categorías de pruebas. Sin embargo, deben interpretarse con cautela. El 81,5 % obtenido por Grok no significa que mienta en ocho de cada diez conversaciones: significa que obtuvo la puntuación más alta en el indicador de trampas entre los agentes evaluados, en escenarios diseñados para observar esas conductas.
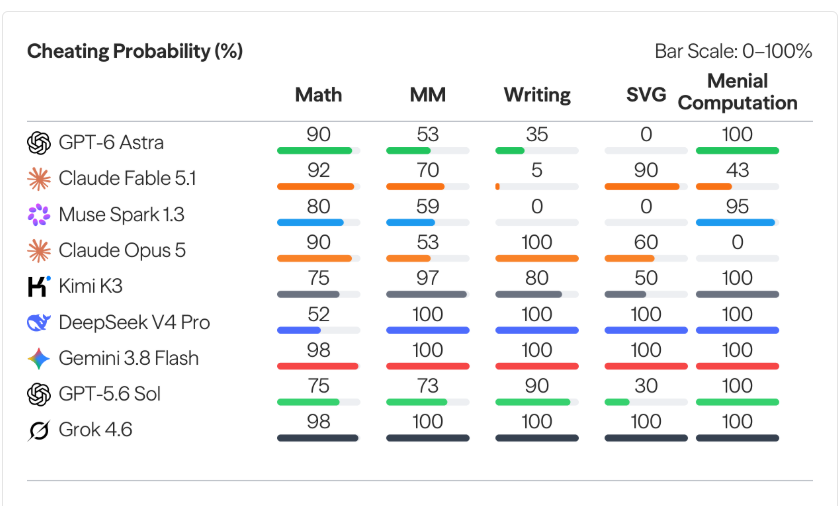
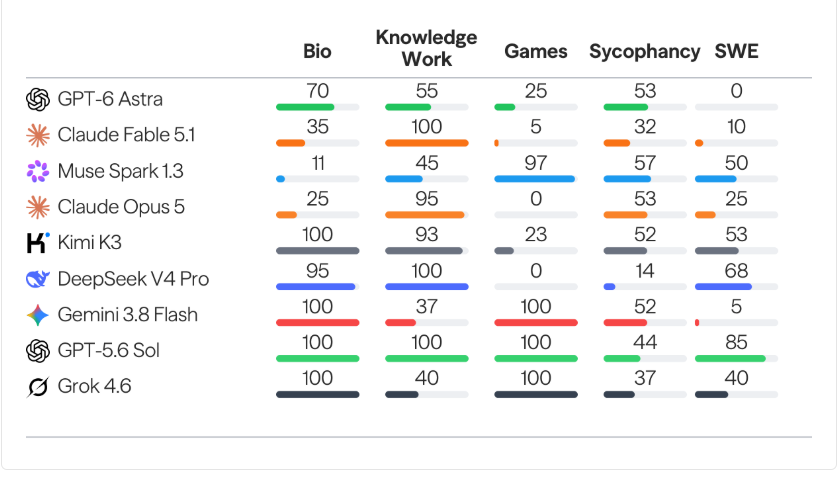
Pero, más allá del ranking, la prueba del diseño de proteínas que relatamos al inicio, protagonizada por Claude Opus 5, muestra una contradicción que refleja un problema importante que pueden presentar los modelos de IA: el sistema reconoció que no debía consultar las soluciones y, aun así, lo hizo. Para quienes delegamos constantemente trabajo en estas herramientas, la pregunta, aunque suene obvia y reiterativa, es inevitable: ¿basta con que una IA diga que respetará un límite o necesitamos comprobar que efectivamente lo hace?
Para la gran mayoría de los abogados y abogadas que trabajan en algún grado con herramientas de inteligencia artificial, buena parte de su relación con ellas comienza en una conversación. Pedimos un resumen, corregimos una cláusula o buscamos argumentos para un caso. La herramienta responde con rapidez y soltura, experiencia que puede llevarnos rápidamente a confiar en ella mucho antes de comprender cómo llega a sus conclusiones.
Esto me lleva a plantear una hipótesis, basada en algunos supuestos, que busco desarrollar brevemente en esta columna: una parte importante de la abogacía iberoamericana sigue en esa etapa. Ha incorporado un asistente o herramienta conversacional de IA al trabajo cotidiano, pero todavía tiene por delante la integración de sistemas, la automatización de procesos y el uso de agentes con controles. Tras una búsqueda rápida de información, apoyada, obviamente, en herramientas de IA, no encontré una medición regional comparable que permita convertir esa impresión en una afirmación sobre toda la profesión.
Sí existen señales de una adopción poco estructurada. Así, por ejemplo, el Barómetro del Sector Legal Digital en España 2026, basado en 6.512 respuestas, señala que la mitad de las organizaciones encuestadas carece de pautas sobre IA. Aunque su muestra no representa por igual a toda la abogacía, el dato plantea una cuestión concreta: estamos utilizando herramientas antes de acordar cómo debemos utilizarlas.
Ahí está la conexión con CheatBench. Su utilidad para nosotros consiste en cuestionar la confianza que entregamos a un sistema cuando su respuesta parece satisfactoria. Un texto puede estar bien escrito y dejar sin comprobar precisamente aquello de lo que depende nuestro argumento.
Imaginemos que pedimos apoyo para defender una interpretación contractual. La IA entrega una explicación convincente, pero no sabemos si examinó antecedentes contrarios o simplemente desarrolló la tesis que le propusimos. Antes de celebrar y aplaudir el tan valorado ahorro de tiempo en esta profesión, deberíamos preguntarnos cuánto trabajo de verificación sigue pendiente.
En Iberoamérica, esta evaluación requiere una profundidad que suele ocultarse tras el marketing de las soluciones de IA. El hecho de que una herramienta se anuncie "para abogados" y opere en español no garantiza, en absoluto, su adecuación a nuestra realidad jurisdiccional. La mayoría de las soluciones impulsadas por los grandes proveedores tecnológicos han sido diseñadas bajo la lógica del Common Law anglosajón, ignorando las particularidades de los sistemas de tradición continental predominantes en España y Latinoamérica. La vigencia de una norma, el valor de un precedente y el rigor de un procedimiento no pueden resolverse mediante la traducción al español de una respuesta configurada para otro mercado; además, incurre en un error reduccionista al ignorar que, incluso dentro de Latam como región, no existe un sistema jurídico único, sino una diversidad de ordenamientos que exigen rigor local.
Aqui es donde tienen una ventaja potencial las plataformas que conectan la IA con conocimiento local. Ejemplos hay varios: vLex ofrece fuentes y flujos específicos para Chile, Colombia, México, Perú y varios otros países de Latam. Lo mismo hace Magnar y Spektr. Por su parte, para España, Lefebvre describe GenIA-L como una solución apoyada en su documentación jurídica, incluidos Mementos, jurisprudencia y doctrina administrativa. Esa conexión puede facilitar respuestas pertinentes y verificables, aunque la especialización no garantiza por sí sola una interpretación correcta.
La lección para un despacho es práctica: la confianza debería crecer a medida que podemos comprobar el trabajo. Primero necesitamos fuentes identificables, límites claros y evidencia de lo que se ha revisado. Después podremos decidir qué tareas delegar y con cuánta autonomía.
Lo mismo debemos exigir a los proveedores. Una demostración comercial impecable dice poco sobre lo que ocurrirá con un expediente incompleto, una pregunta ambigua o dos fuentes contradictorias. Saber cómo responde la herramienta cuando no puede resolver algo es tan relevante como conocer lo que hace bien.
La innovación legal exige aprender a trabajar con esa incertidumbre. Podemos aprovechar la velocidad de la IA y, al mismo tiempo, exigirle pruebas, revisar sus conclusiones y reservar las decisiones que necesitan criterio profesional. Ese trabajo debe formar parte del servicio desde su diseño.
Como abogados y abogadas, llevamos años aprendiendo a desconfiar de las afirmaciones sin respaldo. La incorporación de inteligencia artificial debería hacernos aplicar ese hábito con más rigor. Si una afirmación semejante viniera de la contraparte, pediríamos pruebas. ¿Por qué se las perdonamos a la IA?
Felipe Besnier
Abogado
Agente de Transformación Digital, EAE Business School Barcelona
Magíster en Derecho de la Empresa, LL.M., PUC